De Dev Web a Ingenieur IA
De Dev Web à Ingénieur IA #8 — Query Engine maison
Query Engine maison en TypeScript : retriever, response synthesizer et une façade queryEngine() sans framework
Intro
Dans l’article précédent, on a construit un RAG à la main : on vectorise la question, PostgreSQL compare les distances avec pgvector, et les chunks les plus proches deviennent le contexte du LLM.
Question
  ↓
Embedding de la question
  ↓
Recherche pgvector
  ↓
Top chunks
  ↓
Prompt système
  ↓
Réponse
C’est parfait pour comprendre. Mais quand une application grossit, on ne veut pas répéter cette mécanique partout. On veut une abstraction qui sait :
-
construire la base vectorielle ;
-
récupérer les passages pertinents ;
-
synthétiser une réponse.
C’est exactement le rôle d’un Query Engine.
Aujourd’hui, on va prendre le code de l’article 07 et l’organiser derrière cette façade, à la main. On ne va pas utiliser de framework : le but est de comprendre le pattern Index → Retriever → ResponseSynthesizer → QueryEngine, pour pouvoir le recoder ou l’adapter n’importe où.
Le pattern que l’on veut comprendre
Le QueryEngine est l’abstraction qui relie la récupération des documents et la génération de la réponse finale.
En utilisateur, on veut arriver à :
const response = await queryEngine(
  "Que s'est-il passé avec la livraison Boulangerie Martin ?",
);
L’objectif de cet article est de comprendre le pattern :
Index → Retriever → ResponseSynthesizer → QueryEngineEt de l’implémenter avec de simples fonctions TypeScript.
Le concept : qu’est-ce qu’un Query Engine ?
Un Query Engine est une façade pour poser une question à tes données.
Au lieu d’écrire à chaque requête :
const questionVector = await embed(question);
const rows = await pool.query("SELECT ... ORDER BY embedding <=> ...");
const context = rows.map((row) => row.content).join("\n\n---\n\n");
const answer = await chat(systemPrompt(context), question);
On écrit :
const { chunks, answer } = await queryEngine(question);Le Query Engine cache la plomberie, pas les concepts.
Sous le capot :
QueryEngine
  ├── Retriever : trouve les chunks pertinents
  └── ResponseSynthesizer : transforme les chunks en réponse
Le retriever répond à la question : “quels morceaux de documents dois-je donner au LLM ?”
Le synthesizer répond à la question : “comment produire une réponse à partir de ces morceaux ?”
Le query engine les relie : il appelle le retriever, puis le synthesizer, et retourne les deux résultats.
Les trois briques
Pour chaque brique, on utilise une petite usine (createX) qui retourne une fonction. La fonction garde en mémoire sa configuration :
type Retriever = (question: string) => Promise<SearchResult[]>;

function createRetriever(topK: number): Retriever {
  return async function retrieve(question: string) {
    // topK est connu ici, pas besoin de le passer à chaque appel
  };
}
createRetriever(3) retourne une fonction qui sait retrouver les 3 chunks les plus proches d’une question.
createRetriever(3)
  → une fonction qui sait "trouver les 3 chunks les plus proches"
createResponseSynthesizer()
  → une fonction qui sait "transforme des chunks en réponse"
createQueryEngine(retriever, synthesizer)
  → une fonction qui relie les deux
La composition est explicite : le query engine reçoit le retriever et le synthesizer en paramètres, il n’en crée pas. C’est facile à tester et à remplacer.
Setup
On repart de l’article 07, qui contient déjà toute la mécanique pgvector :
cp -r article-07-embeddings article-08-query-enginecd article-08-query-engine && rm -rf node_modules package-lock.jsonnpm installVérifie que les modèles Ollama sont disponibles :
ollama listIl faut :
qwen3:4b
qwen3-embedding:4b
Si besoin :
ollama pull qwen3:4b
ollama pull qwen3-embedding:4b
Vérifie que PostgreSQL tourne :
docker compose up -ddocker psOn garde la même table que l’article 07 : documents_embeddings. Le Query Engine ne change pas le stockage, il réorganise le code qui l’utilise.
Le code
Remplace le contenu de src/index.ts par ceci :
import { readFileSync, readdirSync } from "node:fs";
import { join, dirname } from "node:path";
import { fileURLToPath } from "node:url";
import pg from "pg";

const { Pool } = pg;

const CHAT_MODEL = "qwen3:4b";
const EMBED_MODEL = "qwen3-embedding:4b";
const OLLAMA_BASE = process.env.OLLAMA_HOST ?? "http://localhost:11434";
const DATAS_DIR = join(
  dirname(fileURLToPath(import.meta.url)),
  "..",
  "..",
  "datas",
);
const EMBED_DIM = 2560;

const pool = new Pool({
  host: process.env.PGHOST ?? "localhost",
  port: Number(process.env.PGPORT ?? 5432),
  user: process.env.PGUSER ?? "blog",
  password: process.env.PGPASSWORD ?? "blog",
  database: process.env.PGDATABASE ?? "blog",
});

type SearchResult = {
  filename: string;
  content: string;
  distance: number;
};

// ─── Embeddings via Ollama

async function embed(text: string): Promise<number[]> {
  const res = await fetch(`${OLLAMA_BASE}/api/embed`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ model: EMBED_MODEL, input: text }),
  });

  if (!res.ok) {
    throw new Error(`Embedding HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { embeddings: number[][] };
  return data.embeddings[0];
}

function toPgVector(vector: number[]): string {
  return `[${vector.join(",")}]`;
}

async function chat(system: string, user: string): Promise<string> {
  const res = await fetch(`${OLLAMA_BASE}/api/chat`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({
      model: CHAT_MODEL,
      messages: [
        { role: "system", content: system },
        { role: "user", content: user },
      ],
      stream: false,
    }),
  });

  if (!res.ok) {
    throw new Error(`Chat HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { message: { content: string } };
  return data.message.content;
}

// ─── Retriever : question → chunks pertinents

type Retriever = (question: string) => Promise<SearchResult[]>;

function createRetriever(topK: number): Retriever {
  return async function retrieve(question: string) {
    const questionVector = await embed(question);

    const result = await pool.query<SearchResult>(
      `SELECT
         filename,
         content,
         embedding <=> $1::vector AS distance
       FROM documents_embeddings
       ORDER BY distance ASC
       LIMIT $2`,
      [toPgVector(questionVector), topK],
    );

    return result.rows;
  };
}

// ─── ResponseSynthesizer : chunks + question → réponse

type ResponseSynthesizer = (
  chunks: SearchResult[],
  question: string,
) => Promise<string>;

function createResponseSynthesizer(): ResponseSynthesizer {
  return async function synthesize(chunks, question) {
    const context = chunks
      .map(
        (chunk) =>
          `[${chunk.filename} | distance ${Number(chunk.distance).toFixed(4)}]\n${chunk.content}`,
      )
      .join("\n\n---\n\n");

    const systemPrompt =
      `Tu es un assistant spécialisé dans les documents d'entreprise. ` +
      `Réponds UNIQUEMENT à partir du contexte fourni. ` +
      `Si le contexte ne contient pas la réponse, dis-le honnêtement. ` +
      `Réponds en français.\n\nContexte :\n${context}`;

    return chat(systemPrompt, question);
  };
}

// ─── QueryEngine : la façade qui relie les deux

type QueryEngine = (question: string) => Promise<{
  chunks: SearchResult[];
  answer: string;
}>;

function createQueryEngine(
  retriever: Retriever,
  synthesizer: ResponseSynthesizer,
): QueryEngine {
  return async function query(question: string) {
    const chunks = await retriever(question);
    const answer = await synthesizer(chunks, question);
    return { chunks, answer };
  };
}

// ─── Ingestion (identique à l'article 07)

async function resetTable() {
  await pool.query("DROP TABLE IF EXISTS documents_embeddings");
  await pool.query("CREATE EXTENSION IF NOT EXISTS vector");
  await pool.query(`
    CREATE TABLE documents_embeddings (
      id SERIAL PRIMARY KEY,
      filename TEXT NOT NULL,
      chunk_index INT NOT NULL,
      content TEXT NOT NULL,
      embedding vector(${EMBED_DIM})
    )
  `);
}

function loadDocuments(): Array<{ filename: string; chunks: string[] }> {
  const files = readdirSync(DATAS_DIR)
    .filter((file) => /^document-\d+\.txt$/.test(file))
    .sort();

  return files.map((filename) => {
    const content = readFileSync(join(DATAS_DIR, filename), "utf-8").trim();
    const chunks = content
      .split(/\n\n+/)
      .map((chunk) => chunk.trim())
      .filter(Boolean);

    return { filename, chunks };
  });
}

async function ingestDocuments() {
  console.log("\n=== Ingestion dans pgvector ===\n");

  const documents = loadDocuments();
  let totalChunks = 0;

  for (const document of documents) {
    for (let i = 0; i < document.chunks.length; i++) {
      const chunk = document.chunks[i];
      const vector = await embed(chunk);

      await pool.query(
        `INSERT INTO documents_embeddings
         (filename, chunk_index, content, embedding)
         VALUES ($1, $2, $3, $4)`,
        [document.filename, i, chunk, toPgVector(vector)],
      );

      totalChunks++;
      console.log(
        `  ✓ ${document.filename} #${i} (${chunk.length} chars, ${vector.length} dimensions)`,
      );
    }
  }

  console.log(`\n${totalChunks} chunks vectorisés et stockés.`);
}

async function withSpinner<T>(label: string, fn: () => Promise<T>): Promise<T> {
  const frames = ["⠋", "⠙", "⠹", "⠸", "⠼", "⠴", "⠦", "⠧", "⠇", "⠏"];
  let i = 0;
  const interval = setInterval(() => {
    process.stdout.write(`\r${frames[i]} ${label}`);
    i = (i + 1) % frames.length;
  }, 80);

  try {
    const result = await fn();
    process.stdout.write(`\r✓ ${label}\n`);
    return result;
  } catch (e) {
    process.stdout.write(`\r✗ ${label}\n`);
    throw e;
  } finally {
    clearInterval(interval);
  }
}

// ─── Requêtes

async function ask(queryEngine: QueryEngine, question: string) {
  console.log(`\n❓ Question : ${question}\n`);

  const { chunks, answer } = await queryEngine(question);

  console.log("Sources récupérées :\n");

  for (const [index, chunk] of chunks.entries()) {
    const preview = chunk.content.slice(0, 180).replace(/\s+/g, " ");
    console.log(
      `  #${index + 1} distance=${Number(chunk.distance).toFixed(4)} ${chunk.filename}`,
    );
    console.log(`     ${preview}...\n`);
  }

  console.log("🤖 Réponse :\n");
  console.log(answer);
}

// ─── Point d'entrée

async function main() {
  console.log("\n=== Chargement des documents ===\n");

  const documents = loadDocuments();
  console.log(`${documents.length} documents chargés depuis ../datas`);

  console.log("\n=== Construction de la base vectorielle ===\n");

  await withSpinner("Réinitialisation de la table...", resetTable);
  await ingestDocuments();

  console.log("\n=== Création du Query Engine ===\n");

  const retriever = createRetriever(3);
  const synthesizer = createResponseSynthesizer();
  const queryEngine = createQueryEngine(retriever, synthesizer);

  console.log("Query Engine prêt.");

  await ask(
    queryEngine,
    "Que s'est-il passé avec la livraison Boulangerie Martin ?",
  );

  await ask(
    queryEngine,
    "Quelles actions ont été décidées après les ventes de juin ?",
  );

  await pool.end();
}

main().catch(async (err) => {
  console.error(`\nErreur : ${err.message}`);
  await pool.end();
  process.exit(1);
});
Exécution
Lance :
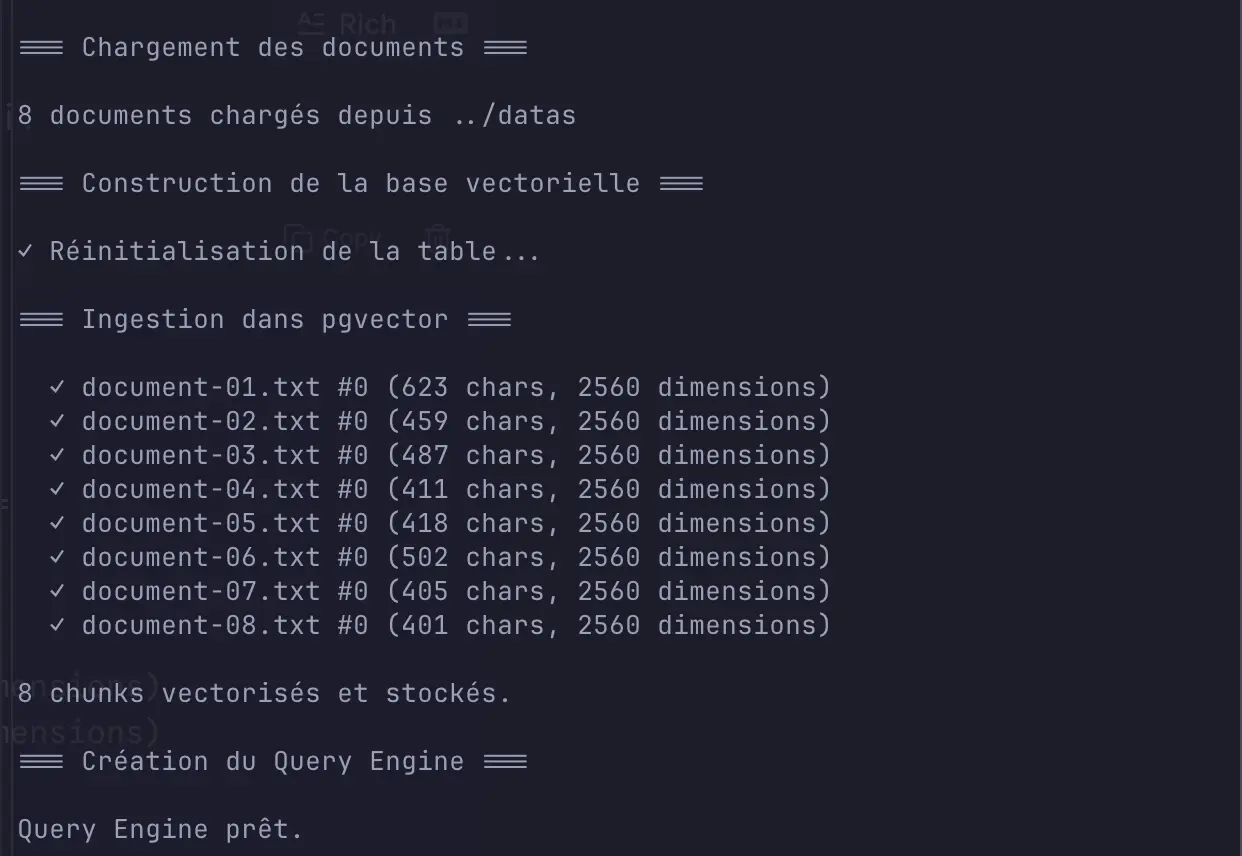
npm startTu devrais voir une première partie comme celle-ci :
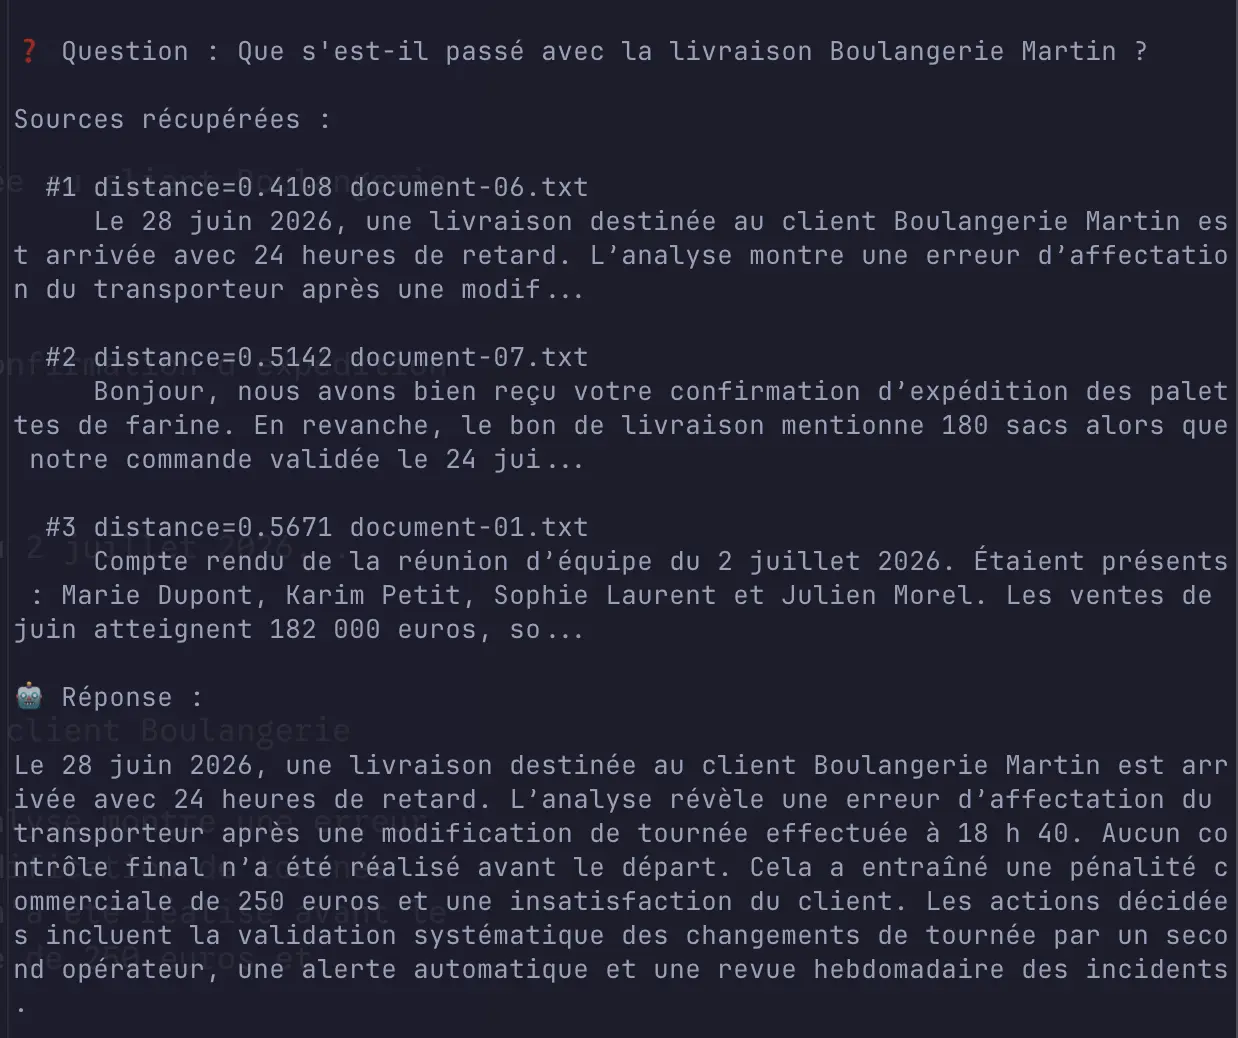
Puis les réponses. Les distances sont les mêmes que dans l’article 07, puisque c’est exactement le même retriever pgvector :
Sur la deuxième question, le Query Engine doit retrouver les documents qui parlent des ventes de juin :
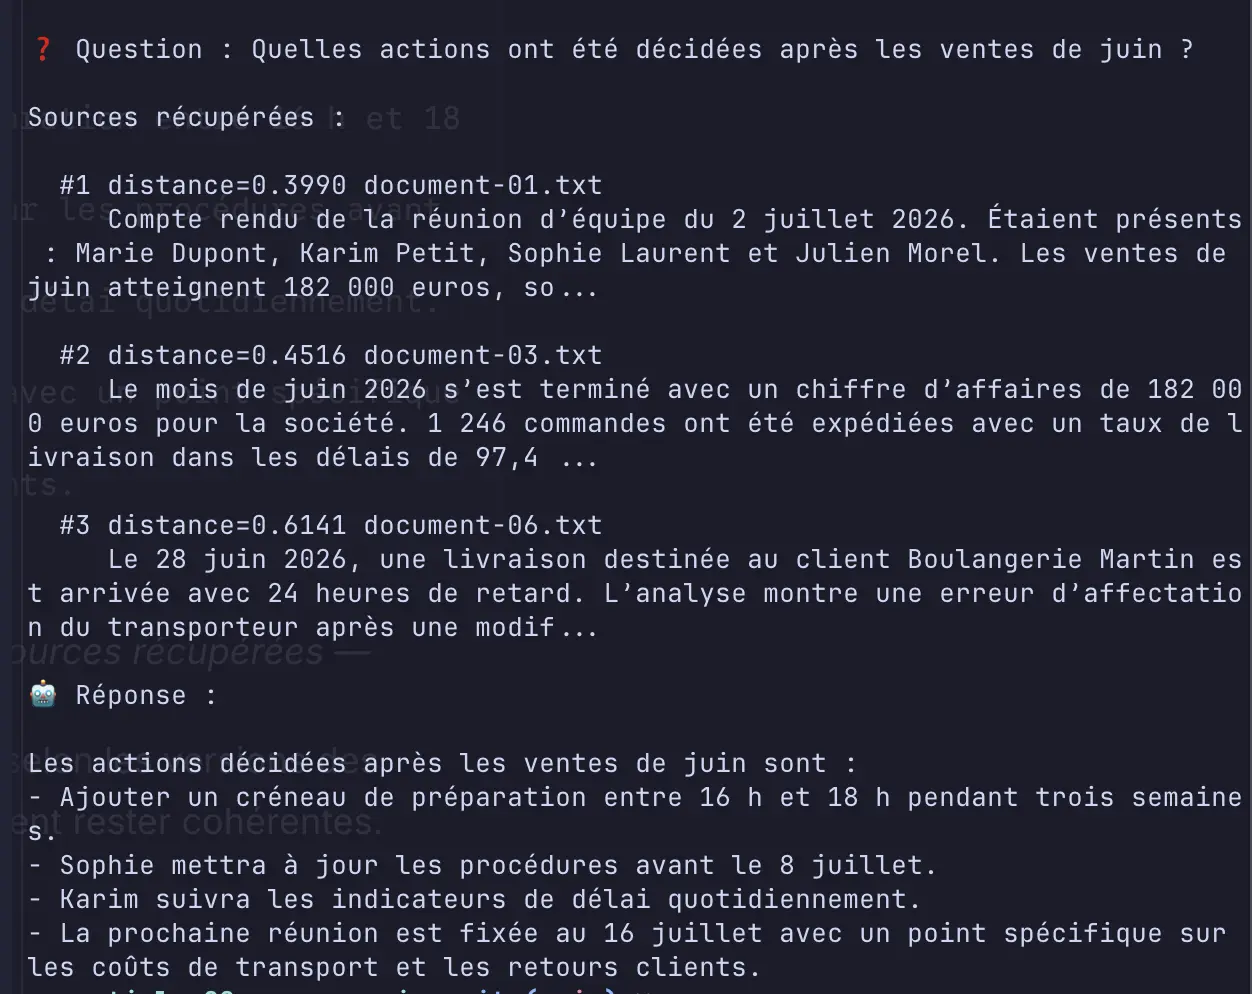
Les distances exactes peuvent légèrement varier selon les versions des modèles locaux, mais les sources principales doivent rester cohérentes.
Ce que le Query Engine fait pour nous
Dans l’article 07, on gérait tout dans une seule fonction ask :
const results = await vectorSearch(question, 3);
const context = results
  .map((result) => `[${result.filename}]\n${result.content}`)
  .join("\n\n---\n\n");
const answer = await chat(systemPrompt, question);
Maintenant, cette mécanique est séparée en trois briques :
retriever(question)           → chunks
synthesizer(chunks, question) → réponse
queryEngine(question)         → { chunks, answer }
Mais les étapes sont toujours là :
| Avant (article 07) | Avec le Query Engine maison |
|---|---|
| Vectoriser la question | retriever |
| Requête pgvector top-K | retriever |
| Construire le contexte | response synthesizer |
| Prompt final | response synthesizer |
| Réponse | query engine |
Le Query Engine ne remplace pas ta compréhension. Il donne une structure au code que tu as déjà.
Retriever vs Query Engine
C’est la distinction la plus importante de l’article.
Un retriever récupère du contexte :
question → chunks pertinentsUn query engine produit une réponse :
question → chunks pertinents → réponse du LLMDonc si ton système répond mal, il faut savoir où regarder :
-
le retriever a-t-il trouvé les bons documents ?
-
le synthesizer a-t-il mal résumé un bon contexte ?
-
le prompt autorise-t-il trop d’invention ?
-
topKest-il trop petit ?
Afficher les sources est donc indispensable. Sans les sources, tu ne sais pas si l’erreur vient du retrieval ou de la génération.
Le paramètre qui compte : topK
Le premier paramètre important :
createRetriever(3);Il dit au retriever combien de chunks remonter.
Si topK est trop petit :
-
tu risques de manquer le bon document ;
-
le LLM reçoit peu de contexte ;
-
les réponses peuvent devenir incomplètes.
Si topK est trop grand :
-
tu donnes trop de bruit au LLM ;
-
la réponse peut mélanger plusieurs sujets ;
-
le prompt devient plus lourd.
Pour notre dataset, 3 est suffisant. Sur des documents longs ou hétérogènes, il faudra tester.
C’est un avantage de cette structure : topK est un paramètre de createRetriever, visible et testable, pas un réglage caché.
Et si le contexte ne contient pas la réponse ?
La recherche vectorielle trouve toujours les textes les plus proches, même si aucun ne répond vraiment.
Demande par exemple :
Quel est le chiffre d'affaires prévu pour 2027 ?Aucun document du dossier datas/ ne parle de 2027. Le retriever remontera quand même 3 chunks (simplement parce qu’on lui demande un top 3), mais le synthesizer doit refuser d’inventer :
🤖 Réponse :

Le contexte fourni ne contient aucune information sur le chiffre d'affaires
prévu pour 2027.
C’est le rôle du prompt système : “Si le contexte ne contient pas la réponse, dis-le honnêtement.” Le Query Engine ne garantit pas une bonne réponse, il garantit que la question passe par les bonnes briques.
Pourquoi ne pas utiliser un framework ?
Beaucoup de frameworks RAG existent (et tu en croiseras dans des articles ou des offres d’emploi). Pourquoi les avoir ignorés ici ?
-
le framework le plus connu de l’écosystème TypeScript, LlamaIndex.TS, est archivé : le dépôt
run-llama/LlamaIndexTSest archivé depuis avril 2026 et ses packages TypeScript sont deprecated / non maintenus. Recommander cette dépendance pour une nouvelle application TypeScript serait une mauvaise idée ; -
le pattern est plus important que la bibliothèque :
retriever → response synthesizer → query enginese code en une trentaine de lignes, comme on vient de le faire. Tu comprends chaque étape, tu peux la modifier, la tester, la remplacer ; -
le metadata filtering (prochain article) est une contrainte de base de données : le
WHEREse passe dans PostgreSQL. Un framework qui cache la requête SQL rend ce genre de filtre plus difficile à maîtriser.
Pour une vraie application TypeScript, une implémentation maison sur PostgreSQL + pgvector est plus saine. Le pattern reste le même partout.
Ce qu’on a appris
-
Query Engine — une façade qui reçoit une question et retourne une réponse basée sur les documents
-
Retriever — une fonction qui récupère les chunks pertinents (
createRetriever) -
ResponseSynthesizer — une fonction qui transforme les chunks en réponse finale (
createResponseSynthesizer) -
Composition — le query engine reçoit ses briques en paramètres, il ne les crée pas
-
Usines —
createRetriever(3)retourne une fonction qui garde sa configuration en mémoire -
topK— règle le nombre de morceaux récupérés -
Sources — indispensables pour debugger le RAG
Le point clé : un Query Engine ne rend pas le RAG magique. Il rend le pipeline plus propre.
Avant, on avait des fonctions séparées. Maintenant, on a une façade qui exprime l’intention :
const { chunks, answer } = await queryEngine(question);Et c’est exactement ce qu’on veut dans un backend d’agent : des briques simples, composables, et inspectables.
Prochain article
De Dev Web à Ingénieur IA #9 — Metadata Filtering — jusqu’ici, on cherche dans tous les documents. Maintenant, on va apprendre à filtrer par source, date, type de document ou tenant avant de lancer la recherche vectorielle.