De Dev Web a Ingenieur IA
De Dev Web à Ingénieur IA #7 — Embeddings & Vector Search
Embeddings, distance cosinus et pgvector : comment transformer le texte en vecteurs et retrouver les bons documents
Intro
Dans l’article précédent, on a vu que le chunking peut faire réussir ou échouer un système RAG. Même avec le bon modèle, une information mal découpée peut ne jamais remonter dans le contexte.
Mais il reste une question importante : comment la recherche sait qu’un chunk est pertinent ?
Quand on écrit :
ORDER BY embedding <=> $1::vector
LIMIT 3
PostgreSQL ne comprend pas le français. Il ne sait pas ce qu’est une livraison, un congé, une réunion ou un fournisseur. Il compare seulement des listes de nombres.
Ces listes de nombres, ce sont les embeddings.
Aujourd’hui, on va ouvrir cette boîte noire : transformer du texte en vecteurs, mesurer la distance entre deux phrases, puis utiliser pgvector pour retrouver les bons documents.
Le concept : un texte devient un point dans l’espace
Un modèle d’embedding transforme un texte en vecteur :
"livraison en retard chez Boulangerie Martin"
        ↓
[0.021, -0.184, 0.732, ..., -0.095]
Ce vecteur ne représente pas les mots un par un. Il représente le sens global du texte.
L’idée centrale :
-
deux textes proches en sens auront des vecteurs proches ;
-
deux textes sans rapport auront des vecteurs éloignés ;
-
une question et un document pertinent devraient finir dans la même zone de l’espace.
Exemple :
"La livraison est arrivée avec 24 heures de retard"
"Le transporteur a livré le client le lendemain"
Ces phrases n’utilisent pas exactement les mêmes mots, mais elles parlent du même événement. Un bon modèle d’embedding doit les placer proches.
À l’inverse :
"La livraison est arrivée avec 24 heures de retard"
"Les congés d'été doivent être validés avant le 15 juillet"
Même si les deux phrases sont en français et parlent d’une entreprise, elles n’ont pas le même sujet. Leurs vecteurs doivent être plus éloignés.
Similarité, distance et recherche vectorielle
Dans pgvector, on ne demande pas “trouve-moi le document qui contient le mot livraison”. On demande plutôt :
“Voici le vecteur de ma question. Quels vecteurs de documents sont les plus proches ?”
Pour ça, pgvector fournit plusieurs opérateurs. Dans cette série, on utilise :
embedding <=> query_embedding<=> calcule la distance cosinus.
Important : c’est une distance, pas un score de similarité.
-
0.12= très proche ; -
0.35= assez proche ; -
0.80= probablement hors sujet.
Donc on trie par distance croissante :
SELECT filename, content, embedding <=> $1::vector AS distance
FROM documents_embeddings
ORDER BY distance ASC
LIMIT 3;
Le premier résultat est celui dont le vecteur est le plus proche de la question.
Pourquoi vectoriser aussi la question ?
Pendant l’ingestion, on vectorise les documents :
document-01.txt → chunk → embedding → PostgreSQL
document-02.txt → chunk → embedding → PostgreSQL
document-03.txt → chunk → embedding → PostgreSQL
Pendant la requête, on vectorise la question :
"Que s'est-il passé avec Boulangerie Martin ?"
        ↓
query embedding
Ensuite, on compare :
query embedding ↔ document embeddingsC’est exactement le même modèle d’embedding des deux côtés. C’est crucial : si tu changes de modèle entre l’ingestion et la requête, les vecteurs ne vivent plus dans le même espace. La comparaison n’a plus de sens.
Dimension : combien de nombres dans un embedding ?
Le modèle qwen3-embedding:4b utilisé dans cette série produit par défaut des vecteurs de 2560 dimensions.
Ça veut dire :
un texte → 2560 nombresLa dimension dépend du modèle :
| Modèle | Dimension typique |
|---|---|
| all-minilm | 384 |
| nomic-embed-text | 768 |
| text-embedding-3-small | 1536 |
| qwen3-embedding:4b | 2560 par défaut |
Une dimension plus grande permet souvent de capturer plus de nuances, mais elle coûte plus cher en stockage et en calcul. Pour notre stack locale, qwen3-embedding:4b reste un bon choix : gratuit, local, et suffisant pour apprendre les mécaniques d’un RAG moderne.
Setup
On repart du dossier de l’article 06 :
cp -r article-06-chunking article-07-embeddingscd article-07-embeddings && rm -rf node_modules package-lock.jsonnpm installVérifie que les modèles Ollama sont disponibles :
ollama listIl faut au minimum :
qwen3:4b
qwen3-embedding:4b
Si le modèle d’embedding n’est pas installé :
ollama pull qwen3-embedding:4bVérifie que PostgreSQL tourne :
docker compose up -ddocker psLes données utilisées sont les 8 documents courts de l’article 05 :
ls ../datas/document-*.txtLe code
Remplace le contenu de src/index.ts par ceci :
import { readFileSync, readdirSync } from "node:fs";
import { join, dirname } from "node:path";
import { fileURLToPath } from "node:url";
import pg from "pg";

const { Pool } = pg;

// ─── Configuration

const CHAT_MODEL = "qwen3:4b";
const EMBED_MODEL = "qwen3-embedding:4b";
const OLLAMA_BASE = process.env.OLLAMA_HOST ?? "http://localhost:11434";
const DATAS_DIR = join(
  dirname(fileURLToPath(import.meta.url)),
  "..",
  "..",
  "datas",
);
const EMBED_DIM = 2560;

const pool = new Pool({
  host: process.env.PGHOST ?? "localhost",
  port: Number(process.env.PGPORT ?? 5432),
  user: process.env.PGUSER ?? "blog",
  password: process.env.PGPASSWORD ?? "blog",
  database: process.env.PGDATABASE ?? "blog",
});

type SearchResult = {
  filename: string;
  content: string;
  distance: number;
};

// ─── Embeddings via Ollama

async function embed(text: string): Promise<number[]> {
  const res = await fetch(`${OLLAMA_BASE}/api/embed`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ model: EMBED_MODEL, input: text }),
  });

  if (!res.ok) {
    throw new Error(`Embedding HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { embeddings: number[][] };
  return data.embeddings[0];
}

function toPgVector(vector: number[]): string {
  return `[${vector.join(",")}]`;
}

// ─── Distance cosinus côté TypeScript

function cosineDistance(a: number[], b: number[]): number {
  if (a.length !== b.length) {
    throw new Error(`Dimensions incompatibles : ${a.length} vs ${b.length}`);
  }

  let dot = 0;
  let normA = 0;
  let normB = 0;

  for (let i = 0; i < a.length; i++) {
    dot += a[i] * b[i];
    normA += a[i] * a[i];
    normB += b[i] * b[i];
  }

  const similarity = dot / (Math.sqrt(normA) * Math.sqrt(normB));
  return 1 - similarity;
}

async function compareSentences() {
  console.log("\n=== Expérience 1 : distances entre phrases ===\n");

  const reference =
    "La livraison destinée à Boulangerie Martin est arrivée avec 24 heures de retard.";

  const candidates = [
    "Le client Boulangerie Martin a été livré le lendemain à cause d'un retard transporteur.",
    "Une pénalité commerciale a été appliquée après un incident de livraison.",
    "Les congés d'été doivent être posés avant le 15 juillet.",
    "Le nouveau portail de chargement sera accessible aux chauffeurs externes.",
  ];

  const referenceVector = await embed(reference);

  console.log(`Phrase de référence : ${reference}\n`);

  for (const candidate of candidates) {
    const candidateVector = await embed(candidate);
    const distance = cosineDistance(referenceVector, candidateVector);
    console.log(`${distance.toFixed(4)}  ${candidate}`);
  }

  console.log(
    "\nPlus la distance est basse, plus les phrases sont proches sémantiquement.",
  );
}

// ─── PostgreSQL + pgvector

async function resetTable() {
  await pool.query("DROP TABLE IF EXISTS documents_embeddings");
  await pool.query("CREATE EXTENSION IF NOT EXISTS vector");
  await pool.query(`
    CREATE TABLE documents_embeddings (
      id SERIAL PRIMARY KEY,
      filename TEXT NOT NULL,
      chunk_index INT NOT NULL,
      content TEXT NOT NULL,
      embedding vector(${EMBED_DIM})
    )
  `);
}

function loadDocuments(): Array<{ filename: string; chunks: string[] }> {
  const files = readdirSync(DATAS_DIR)
    .filter((file) => /^document-\d+\.txt$/.test(file))
    .sort();

  return files.map((filename) => {
    const content = readFileSync(join(DATAS_DIR, filename), "utf-8").trim();
    const chunks = content
      .split(/\n\n+/)
      .map((chunk) => chunk.trim())
      .filter(Boolean);

    return { filename, chunks };
  });
}

async function ingestDocuments() {
  console.log("\n=== Expérience 2 : ingestion dans pgvector ===\n");

  const documents = loadDocuments();
  let totalChunks = 0;

  for (const document of documents) {
    for (let i = 0; i < document.chunks.length; i++) {
      const chunk = document.chunks[i];
      const vector = await embed(chunk);

      await pool.query(
        `INSERT INTO documents_embeddings
         (filename, chunk_index, content, embedding)
         VALUES ($1, $2, $3, $4)`,
        [document.filename, i, chunk, toPgVector(vector)],
      );

      totalChunks++;
      console.log(
        `  ✓ ${document.filename} #${i} (${chunk.length} chars, ${vector.length} dimensions)`,
      );
    }
  }

  console.log(`\n${totalChunks} chunks vectorisés et stockés.`);
}

async function vectorSearch(
  question: string,
  limit = 3,
): Promise<SearchResult[]> {
  const questionVector = await embed(question);

  const result = await pool.query<SearchResult>(
    `SELECT
       filename,
       content,
       embedding <=> $1::vector AS distance
     FROM documents_embeddings
     ORDER BY distance ASC
     LIMIT $2`,
    [toPgVector(questionVector), limit],
  );

  return result.rows;
}

async function chat(system: string, user: string): Promise<string> {
  const res = await fetch(`${OLLAMA_BASE}/api/chat`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({
      model: CHAT_MODEL,
      messages: [
        { role: "system", content: system },
        { role: "user", content: user },
      ],
      stream: false,
    }),
  });

  if (!res.ok) {
    throw new Error(`Chat HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { message: { content: string } };
  return data.message.content;
}

async function ask(question: string) {
  console.log(`\n❓ Question : ${question}\n`);

  const results = await vectorSearch(question, 3);

  console.log("Résultats vectoriels :\n");
  for (const [index, result] of results.entries()) {
    const preview = result.content.slice(0, 160).replace(/\s+/g, " ");
    console.log(
      `  #${index + 1} distance=${Number(result.distance).toFixed(4)} ${result.filename}`,
    );
    console.log(`     ${preview}...\n`);
  }

  const context = results
    .map(
      (result) =>
        `[${result.filename} | distance ${Number(result.distance).toFixed(4)}]\n${result.content}`,
    )
    .join("\n\n---\n\n");

  const systemPrompt =
    `Tu es un assistant spécialisé dans les documents d'entreprise. ` +
    `Réponds UNIQUEMENT à partir du contexte fourni. ` +
    `Si le contexte ne contient pas la réponse, dis-le honnêtement. ` +
    `Réponds en français.\n\nContexte :\n${context}`;

  const answer = await chat(systemPrompt, question);
  console.log(`🤖 Réponse :\n${answer}\n`);
}

// ─── Spinner

async function withSpinner<T>(label: string, fn: () => Promise<T>): Promise<T> {
  const frames = ["⠋", "⠙", "⠹", "⠸", "⠼", "⠴", "⠦", "⠧", "⠇", "⠏"];
  let i = 0;
  const interval = setInterval(() => {
    process.stdout.write(`\r${frames[i]} ${label}`);
    i = (i + 1) % frames.length;
  }, 80);

  try {
    const result = await fn();
    process.stdout.write(`\r✓ ${label}\n`);
    return result;
  } catch (e) {
    process.stdout.write(`\r✗ ${label}\n`);
    throw e;
  } finally {
    clearInterval(interval);
  }
}

// ─── Point d'entrée

async function main() {
  await compareSentences();

  await withSpinner("\nRéinitialisation de la table...", resetTable);
  await ingestDocuments();

  console.log("\n=== Expérience 3 : recherche vectorielle ===\n");

  await ask("Que s'est-il passé avec la livraison Boulangerie Martin ?");
  await ask("Quelles actions ont été décidées après les ventes de juin ?");

  await pool.end();
}

main().catch(async (err) => {
  console.error(`\nErreur : ${err.message}`);
  await pool.end();
  process.exit(1);
});
Exécution
Lance le script :
npm startTu devrais voir d’abord une comparaison de phrases :
=== Expérience 1 : distances entre phrases ===

Phrase de référence : La livraison destinée à Boulangerie Martin est arrivée avec 24 heures de retard.

0.1098  Le client Boulangerie Martin a été livré le lendemain à cause d'un retard transporteur.
0.4761  Une pénalité commerciale a été appliquée après un incident de livraison.
0.7398  Les congés d'été doivent être posés avant le 15 juillet.
0.6882  Le nouveau portail de chargement sera accessible aux chauffeurs externes.
Les nombres exacts peuvent varier selon la version du modèle, mais l’ordre devrait rester logique : la phrase qui raconte le même événement est clairement la plus proche, même si les distances absolues ne sont pas “jolies”.
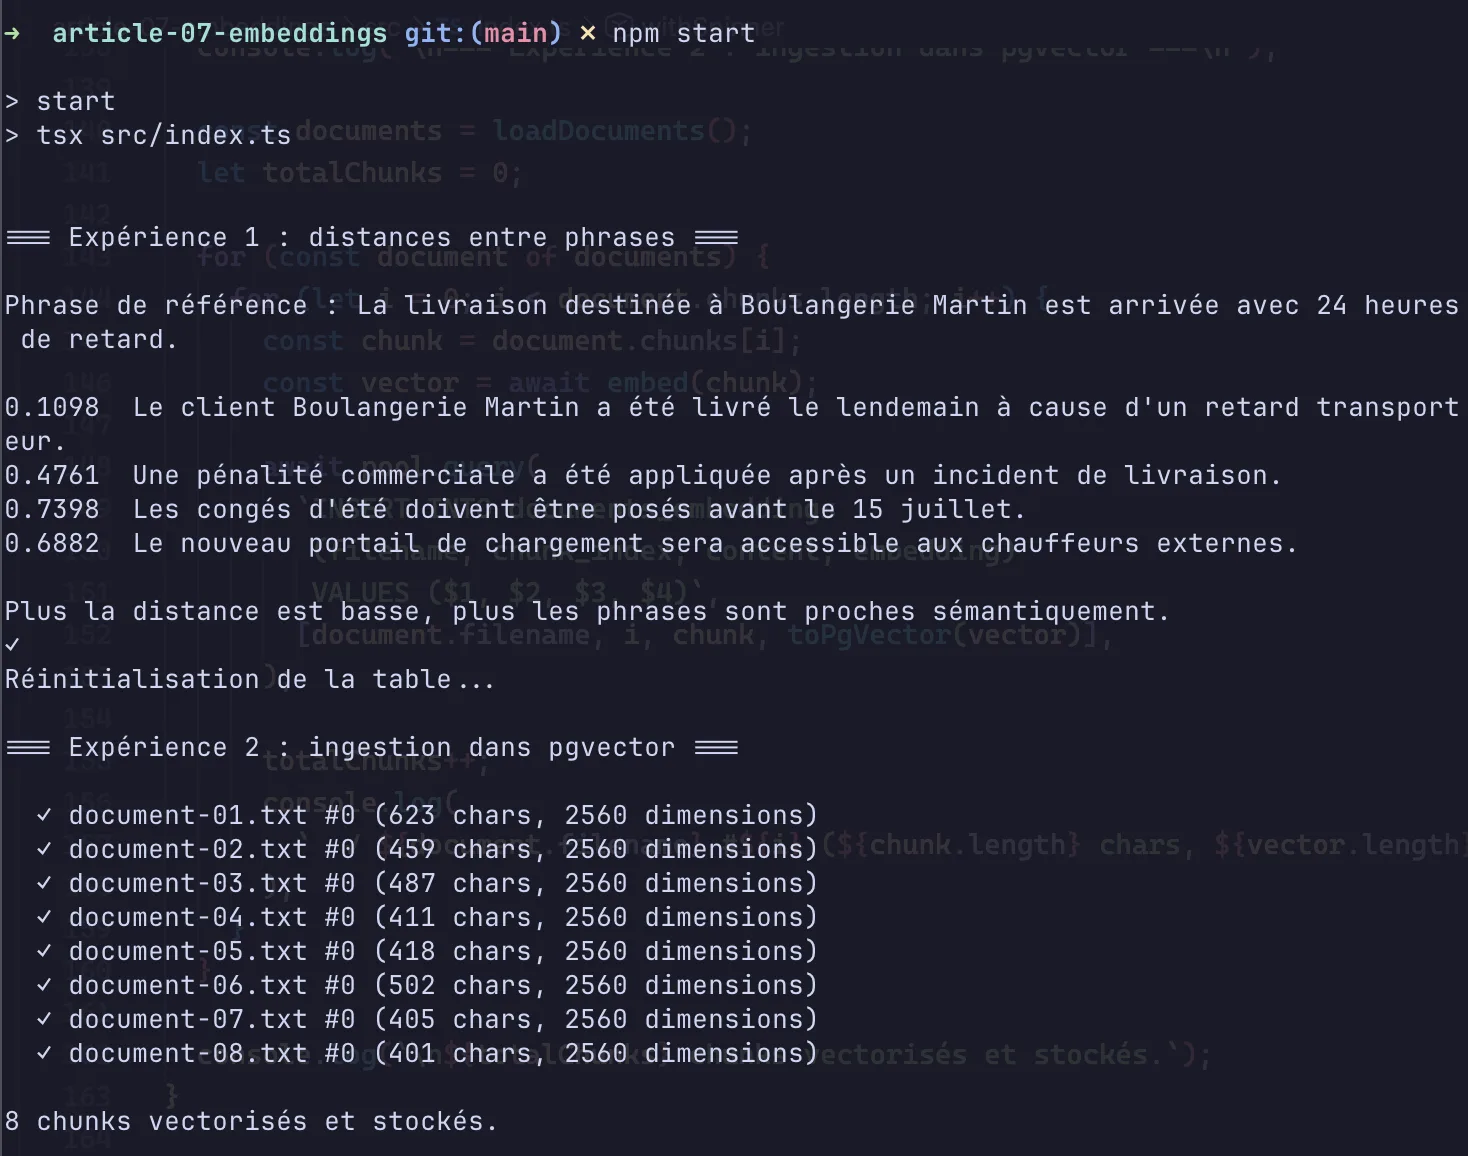
Ensuite, le script ingère les documents :
=== Expérience 2 : ingestion dans pgvector ===

  ✓ document-01.txt #0 (623 chars, 2560 dimensions)
  ✓ document-02.txt #0 (459 chars, 2560 dimensions)
  ✓ document-03.txt #0 (487 chars, 2560 dimensions)
  ✓ document-04.txt #0 (411 chars, 2560 dimensions)
  ✓ document-05.txt #0 (418 chars, 2560 dimensions)
  ✓ document-06.txt #0 (502 chars, 2560 dimensions)
  ✓ document-07.txt #0 (405 chars, 2560 dimensions)
  ✓ document-08.txt #0 (401 chars, 2560 dimensions)

8 chunks vectorisés et stockés.
Enfin, il pose deux questions :
❓ Question : Que s'est-il passé avec la livraison Boulangerie Martin ?

Résultats vectoriels :

  #1 distance=0.4108 document-06.txt
     Le 28 juin 2026, une livraison destinée au client Boulangerie Martin est arrivée avec 24 heures de retard. L’analyse montre une erreur d’affectation du transpor...

  #2 distance=0.5142 document-07.txt
     Bonjour, nous avons bien reçu votre confirmation d’expédition des palettes de farine. En revanche, le bon de livraison mentionne 180 sacs alors que notre comman...

  #3 distance=0.5671 document-01.txt
     Compte rendu de la réunion d’équipe du 2 juillet 2026. Étaient présents : Marie Dupont, Karim Petit, Sophie Laurent et Julien Morel. Les ventes de juin atteigne...

🤖 Réponse :
Le 28 juin 2026, une livraison destinée au client Boulangerie Martin est
arrivée avec 24 heures de retard. L’analyse montre une erreur
d’affectation du transporteur après une modification de tournée
effectuée à 18 h 40. Aucun contrôle final n’a été réalisé avant le
départ. Conséquences : pénalité commerciale de 250 euros et
insatisfaction du client.


❓ Question : Quelles actions ont été décidées après les ventes de juin ?

Résultats vectoriels :

  #1 distance=0.3990 document-01.txt
     Compte rendu de la réunion d’équipe du 2 juillet 2026. Étaient présents : Marie Dupont, Karim Petit, Sophie Laurent et Julien Morel. Les ventes de juin atteigne...

  #2 distance=0.4516 document-03.txt
     Le mois de juin 2026 s’est terminé avec un chiffre d’affaires de 182 000 euros pour la société. 1 246 commandes ont été expédiées avec un taux de livraison dans...

  #3 distance=0.6141 document-06.txt
     Le 28 juin 2026, une livraison destinée au client Boulangerie Martin est arrivée avec 24 heures de retard. L’analyse montre une erreur d’affectation du transpor...

🤖 Réponse :
Il est décidé d’ajouter un créneau de préparation entre 16 h et 18 h
pendant trois semaines. Sophie mettra à jour les procédures avant le
8 juillet. Karim suivra les indicateurs de délai quotidiennement. La
prochaine réunion est fixée au 16 juillet avec un point spécifique sur
les coûts de transport et les retours clients.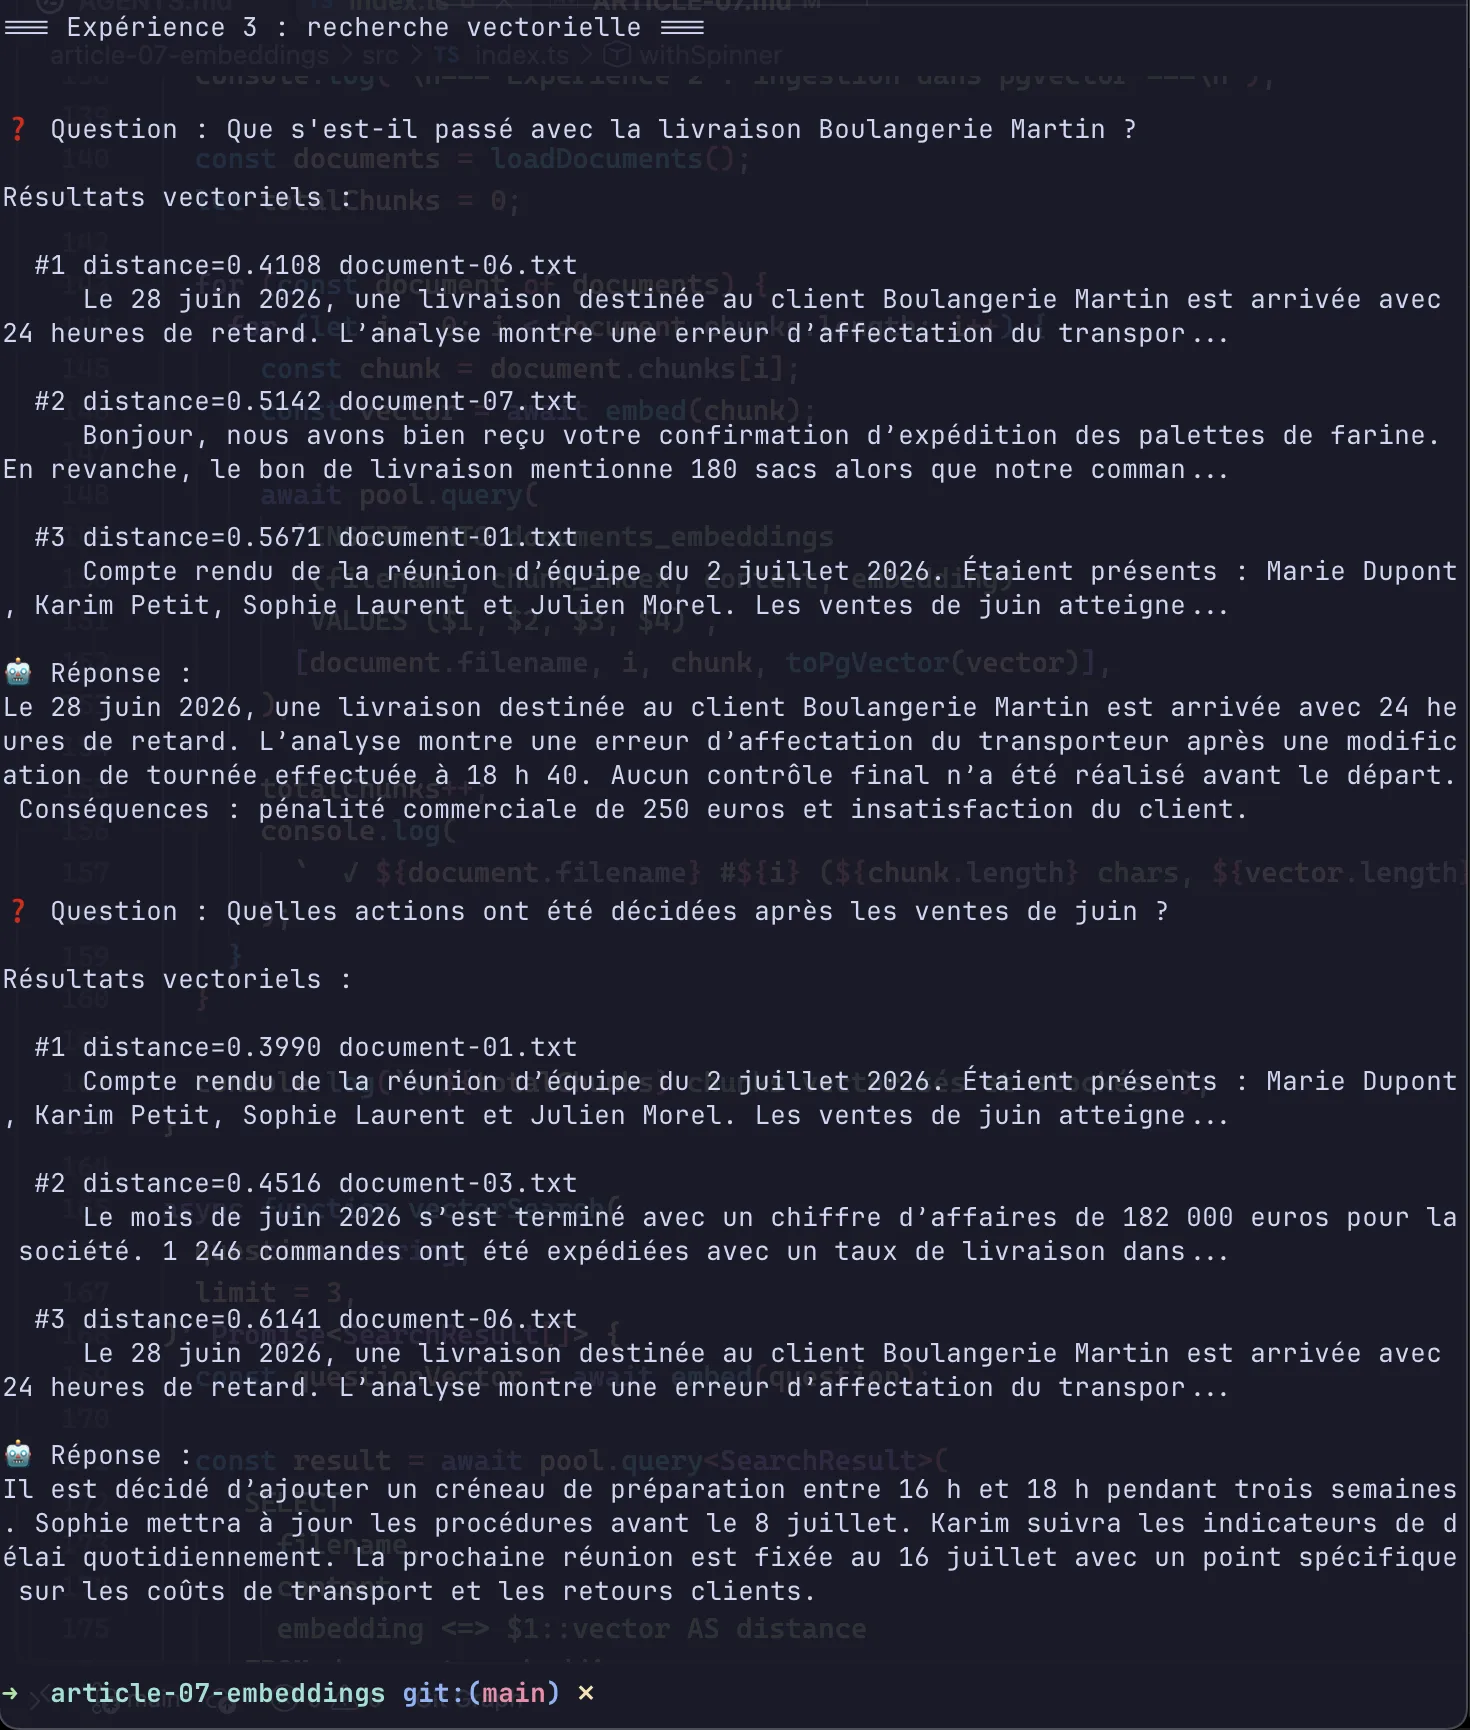
Lire les distances
Le plus important dans l’output n’est pas seulement la réponse du LLM. C’est le classement :
#1 distance=0.4108 document-06.txt
#2 distance=0.5142 document-07.txt
#3 distance=0.5671 document-01.txt
Le document 06 est premier : c’est bien celui qui contient l’incident Boulangerie Martin. Les distances ne sont pas proches de zéro, mais ce n’est pas un problème. Ce qui compte d’abord, c’est le classement relatif : le bon document remonte en tête.
Sur une autre question, les distances peuvent être plus proches :
#1 distance=0.3990 document-01.txt
#2 distance=0.4516 document-03.txt
#3 distance=0.6141 document-06.txt
Là, les deux premiers résultats sont logiques : document-01.txt contient les actions décidées en réunion, et document-03.txt parle aussi des ventes de juin. Ce n’est pas un bug : une question peut toucher plusieurs documents. Les distances aident à voir ce que le retriever considère comme proche.
En pratique, regarder les distances permet de détecter :
-
une question bien couverte par un document précis ;
-
une question ambiguë ;
-
une question hors contexte ;
-
un modèle d’embedding qui rapproche mal certains concepts.
Ce que PostgreSQL stocke vraiment
La table créée par le script ressemble à ça :
CREATE TABLE documents_embeddings (
  id SERIAL PRIMARY KEY,
  filename TEXT NOT NULL,
  chunk_index INT NOT NULL,
  content TEXT NOT NULL,
  embedding vector(2560)
);
content contient le texte lisible.
embedding contient le vecteur :
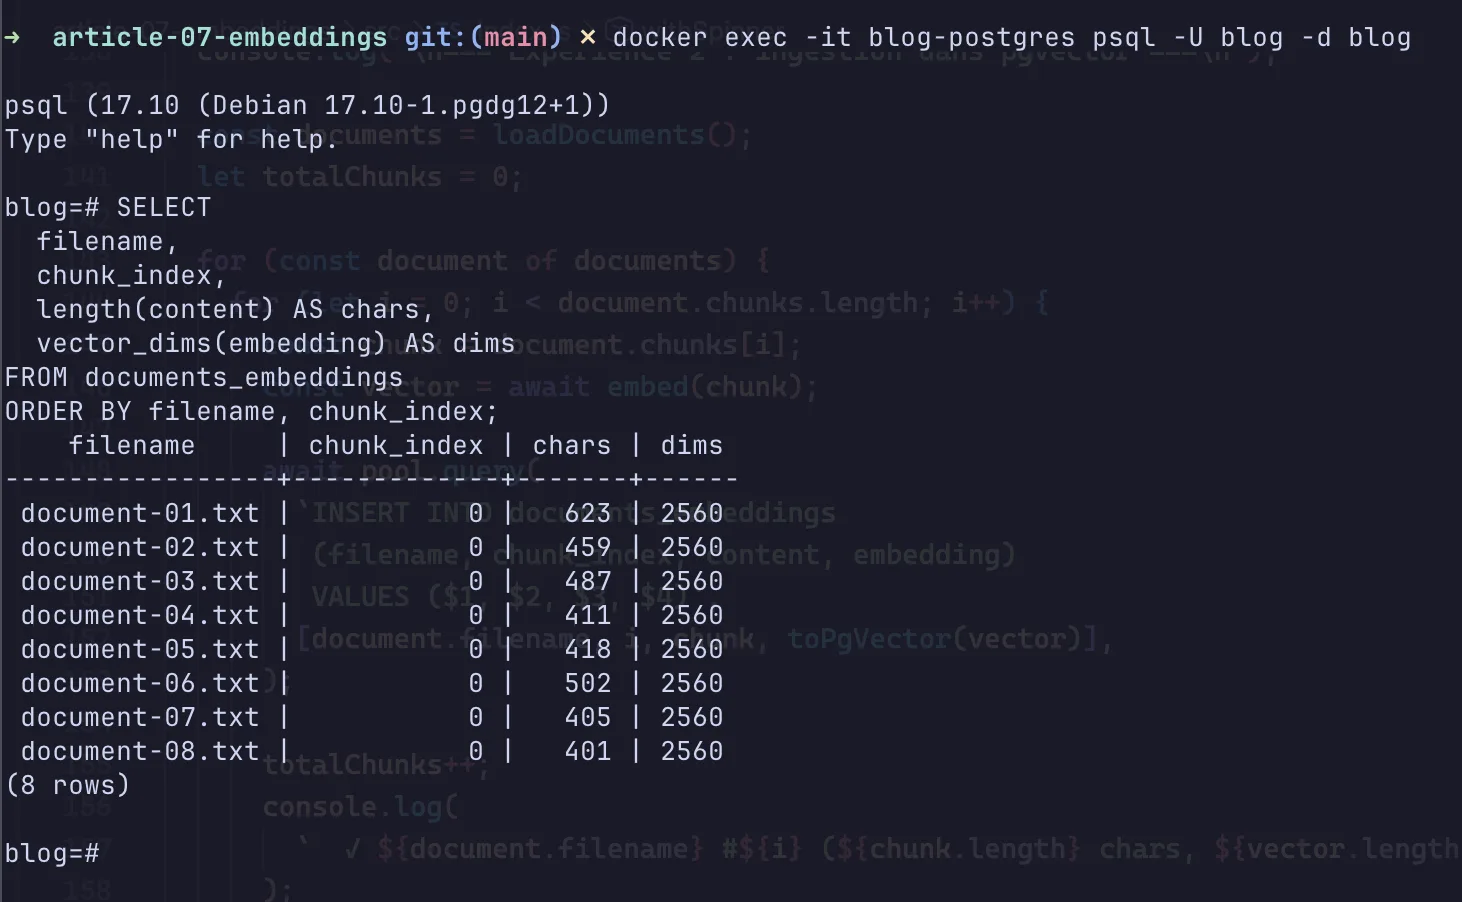
[0.0123, -0.0441, 0.2839, ..., -0.0912]Tu peux inspecter la table avec :
docker exec -it blog-postgres psql -U blog -d blogPuis :
SELECT
  filename,
  chunk_index,
  length(content) AS chars,
  vector_dims(embedding) AS dims
FROM documents_embeddings
ORDER BY filename, chunk_index;
Tu devrais voir :
 filename        | chunk_index | chars | dims
-----------------+-------------+-------+------
 document-01.txt | 0           | 623   | 2560
 document-02.txt | 0           | 459   | 2560
 document-03.txt | 0           | 487   | 2560
 ...
Quitte psql avec :
\qPourquoi ORDER BY embedding <=> ... suffit
La requête centrale est :
SELECT
  filename,
  content,
  embedding <=> $1::vector AS distance
FROM documents_embeddings
ORDER BY distance ASC
LIMIT 3;
Elle fait trois choses :
-
calcule la distance entre le vecteur de la question et chaque embedding stocké ;
-
trie du plus proche au plus éloigné ;
-
garde les 3 meilleurs chunks.
Pour notre dataset de 8 documents, PostgreSQL peut scanner toute la table sans problème.
Sur 100 000 ou 1 million de chunks, on ajouterait un index vectoriel :
CREATE INDEX documents_embeddings_embedding_idx
ON documents_embeddings
USING hnsw (embedding vector_cosine_ops);
On ne l’ajoute pas encore dans le code pour garder l’article focalisé. Les index vectoriels seront plus intéressants quand on parlera performance et production.
Embedding de document vs embedding de question
Un détail qui surprend souvent : on utilise le même endpoint pour les documents et les questions.
const documentVector = await embed(chunk);
const questionVector = await embed(question);
Ce n’est pas un hasard. Le modèle apprend à placer des textes comparables dans un même espace.
Un chunk peut être déclaratif :
Le 28 juin 2026, une livraison destinée au client Boulangerie Martin est arrivée avec 24 heures de retard.La question peut être interrogative :
Que s'est-il passé avec la livraison Boulangerie Martin ?Même structure grammaticale différente, même sujet. Le modèle doit les rapprocher.
C’est ce qui rend la recherche vectorielle plus souple qu’une recherche par mots-clés.
Les limites des embeddings
Les embeddings sont puissants, mais ils ne sont pas magiques.
1. Synonymes et vocabulaire métier
Un bon modèle rapproche “livraison en retard” et “retard transporteur”. Mais sur du vocabulaire très spécifique, acronymes internes, codes produit, références client, la distance peut devenir moins fiable.
Exemple :
"incident BM-2026-06"Si “BM” veut dire “Boulangerie Martin” dans ton entreprise, le modèle ne le sait pas forcément. Il faut parfois enrichir les chunks avec des métadonnées ou garder des mots-clés explicites.
2. Questions ambiguës
"Quelles actions ont été décidées ?"Cette question peut parler de la réunion, de l’incident livraison, des congés, ou du portail de chargement. Le vecteur de la question n’a pas assez d’information pour viser un document précis.
Meilleure question :
"Quelles actions ont été décidées après l'incident Boulangerie Martin ?"Plus la question est précise, plus l’embedding est utile.
3. Information absente
La recherche vectorielle trouve toujours les textes les plus proches. Même si aucun document ne répond vraiment.
Dans ce cas, le système remonte quand même 3 chunks, simplement parce qu’on lui demande un top 3. Mais les distances seront moins convaincantes, et le LLM devra répondre que le contexte ne contient pas l’information.
4. Le modèle d’embedding fixe la qualité du retrieval
Un modèle d’embedding faible peut rapprocher les mauvais documents. Un modèle meilleur peut comprendre plus de nuances.
Mais attention : changer de modèle n’est pas une simple variable d’environnement. Si la dimension change, il faut recréer la table et ré-ingérer les documents.
Pendant ce temps, sous le capot
Quand le script tourne, il fait deux types d’appels Ollama :
/api/embed  → transforme texte/question en vecteur
/api/chat   → génère la réponse finale
L’embedding est utilisé beaucoup plus souvent :
-
une fois par chunk pendant l’ingestion ;
-
une fois par question pendant la recherche.
Le chat n’arrive qu’après, quand les bons chunks sont déjà sélectionnés.
C’est une idée importante en RAG : le LLM ne cherche pas dans les documents. Le retrieval cherche d’abord, le LLM répond ensuite.
Question
  ↓
Embedding de la question
  ↓
Recherche pgvector
  ↓
Top chunks
  ↓
Prompt du LLM
  ↓
Réponse
Ce qu’on a appris
-
Embedding — une représentation numérique du sens d’un texte
-
Dimension — le nombre de valeurs dans le vecteur, ici 2560 avec
qwen3-embedding:4b -
Distance cosinus — mesure utilisée par pgvector avec l’opérateur
<=> -
Recherche vectorielle — on vectorise la question, puis on trie les documents par proximité
-
pgvector — permet de stocker et comparer les embeddings directement dans PostgreSQL
-
Distances visibles — afficher les distances aide à debugger le retrieval
-
Limites — vocabulaire métier, questions ambiguës, informations absentes, qualité du modèle
La recherche vectorielle est le moteur discret du RAG. Le LLM donne l’impression de “connaître” la réponse, mais en réalité la qualité vient souvent de ce qui s’est passé juste avant : le bon chunk est-il remonté ?
Prochain article
De Dev Web à Ingénieur IA #8 — Query Engine maison — maintenant qu’on comprend les briques à la main, on va organiser le code de l’article 07 derrière une façade : retriever, response synthesizer et query engine, sans framework.