De Dev Web a Ingenieur IA
De Dev Web à Ingénieur IA #9 — Metadata Filtering
Métadonnées et filtres SQL avant la recherche vectorielle : source, type, department, tenant, date
Intro
Dans l’article précédent, on a assemblé un Query Engine maison : un retriever qui trouve les chunks pertinents dans pgvector, un response synthesizer qui transforme ce contexte en réponse, et une façade queryEngine(question) qui relie les deux.
Mais notre recherche a encore un gros défaut : elle cherche dans tous les documents.
Dans une vraie application, ce n’est pas acceptable.
Imagine un assistant interne avec :
-
des documents RH ;
-
des contrats clients ;
-
des incidents logistiques ;
-
des notes commerciales ;
-
plusieurs équipes ;
-
plusieurs clients ;
-
plusieurs tenants.
Si un utilisateur pose une question RH, inutile de chercher dans les devis fournisseurs. Si un client A interroge son portail, il ne doit jamais récupérer un document du client B. Si on analyse juillet 2026, les notes de 2024 peuvent être du bruit.
La solution : metadata filtering.
Aujourd’hui, on va ajouter des métadonnées à nos chunks, puis filtrer la recherche vectorielle par source, type, department, tenant et date.
On continue sur notre implémentation maison de l’article 08, sans framework :
-
c’est une contrainte de base de données : le
WHERE tenant = ...se passe dans PostgreSQL, pas dans un framework ; -
le pattern, lui, ne change pas : retriever → synthèse → réponse. On va juste apprendre au retriever à recevoir des filtres.
C’est le dernier changement d’outil : toute la suite de la série reste sur notre implémentation maison.
Le concept : filtrer avant de chercher
La recherche vectorielle répond à cette question :
“Quels chunks sont les plus proches sémantiquement de ma question ?”
Le metadata filtering ajoute une contrainte avant :
“Parmi les chunks autorisés, lesquels sont les plus proches ?”
Sans filtre :
SELECT *
FROM documents
ORDER BY embedding <=> query_vector
LIMIT 3;
Avec filtre :
SELECT *
FROM documents
WHERE tenant = 'demo'
  AND department = 'logistique'
ORDER BY embedding <=> query_vector
LIMIT 3;
La différence est énorme.
Le filtre définit le périmètre. La recherche vectorielle classe les résultats à l’intérieur de ce périmètre.
Pourquoi les métadonnées sont critiques en RAG
Un RAG sans métadonnées est une grande boîte pleine de chunks.
Ça marche pour un tuto. Ça casse en entreprise.
Les métadonnées servent à :
-
sécuriser : isoler les tenants, clients ou utilisateurs ;
-
contextualiser : limiter à un service, une période, une source ;
-
améliorer la pertinence : réduire le bruit avant la recherche vectorielle ;
-
debugger : comprendre d’où vient chaque réponse ;
-
préparer la production : audit, permissions, traçabilité.
Exemples :
tenant: demo
department: logistique
type: incident
source: document-06.txt
date: 2026-06-28
Ces champs ne remplacent pas les embeddings. Ils les encadrent.
Les données
On garde les 8 documents du dossier datas/.
Pour l’article, on va créer les métadonnées directement dans le code, avec une petite table de configuration :
const DOCUMENT_METADATA = {
  "document-01.txt": {
    type: "meeting_notes",
    department: "commercial",
    tenant: "demo",
    documentDate: "2026-07-03",
  },
  "document-06.txt": {
    type: "incident_report",
    department: "logistique",
    tenant: "demo",
    documentDate: "2026-06-28",
  },
};
Dans une vraie application, ces métadonnées viendraient plutôt :
-
d’une table SQL ;
-
du nom du fichier ;
-
d’un CRM ;
-
d’un système de permissions ;
-
d’un pipeline d’ingestion ;
-
d’une extraction automatique par LLM.
Ici, on les écrit à la main pour comprendre.
Setup
On repart de l’article 08, qui contient déjà notre Query Engine maison et la mécanique PostgreSQL + pgvector :
cp -r article-08-query-engine article-09-metadata-filteringcd article-09-metadata-filtering && rm -rf node_modules package-lock.jsonnpm installVérifie les modèles :
ollama listIl faut :
qwen3:4b
qwen3-embedding:4b
Démarre PostgreSQL :
docker compose up -dVérifie :
docker psLe code
Remplace le contenu de src/index.ts par ceci. On reprend le pattern de l’article 08 — createRetriever, createResponseSynthesizer, createQueryEngine — avec deux nouveautés : la table documents_metadata (qui stocke les métadonnées à côté de chaque embedding) et un retriever qui accepte des filtres :
import { readFileSync, readdirSync } from "node:fs";
import { join, dirname } from "node:path";
import { fileURLToPath } from "node:url";
import pg from "pg";

const { Pool } = pg;

const CHAT_MODEL = "qwen3:4b";
const EMBED_MODEL = "qwen3-embedding:4b";
const OLLAMA_BASE = process.env.OLLAMA_HOST ?? "http://localhost:11434";
const DATAS_DIR = join(
  dirname(fileURLToPath(import.meta.url)),
  "..",
  "..",
  "datas",
);
const EMBED_DIM = 2560;

const pool = new Pool({
  host: process.env.PGHOST ?? "localhost",
  port: Number(process.env.PGPORT ?? 5432),
  user: process.env.PGUSER ?? "blog",
  password: process.env.PGPASSWORD ?? "blog",
  database: process.env.PGDATABASE ?? "blog",
});

type DocumentMetadata = {
  type: string;
  department: string;
  tenant: string;
  documentDate: string;
};

type SearchFilters = {
  tenant?: string;
  department?: string;
  type?: string;
  dateFrom?: string;
  dateTo?: string;
};

type RetrievedChunk = {
  filename: string;
  content: string;
  type: string;
  department: string;
  tenant: string;
  document_date: string;
  distance: number;
};

const DOCUMENT_METADATA: Record<string, DocumentMetadata> = {
  "document-01.txt": {
    type: "meeting_notes",
    department: "commercial",
    tenant: "demo",
    documentDate: "2026-07-03",
  },
  "document-02.txt": {
    type: "internal_note",
    department: "operations",
    tenant: "demo",
    documentDate: "2026-07-04",
  },
  "document-03.txt": {
    type: "monthly_report",
    department: "direction",
    tenant: "demo",
    documentDate: "2026-06-30",
  },
  "document-04.txt": {
    type: "supplier_quote",
    department: "achats",
    tenant: "demo",
    documentDate: "2026-07-01",
  },
  "document-05.txt": {
    type: "hr_note",
    department: "rh",
    tenant: "demo",
    documentDate: "2026-07-02",
  },
  "document-06.txt": {
    type: "incident_report",
    department: "logistique",
    tenant: "demo",
    documentDate: "2026-06-28",
  },
  "document-07.txt": {
    type: "supplier_email",
    department: "achats",
    tenant: "demo",
    documentDate: "2026-07-05",
  },
  "document-08.txt": {
    type: "service_note",
    department: "operations",
    tenant: "demo",
    documentDate: "2026-07-06",
  },
};

// ─── Helpers LLM

async function embed(text: string): Promise<number[]> {
  const res = await fetch(`${OLLAMA_BASE}/api/embed`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ model: EMBED_MODEL, input: text }),
  });

  if (!res.ok) {
    throw new Error(`Embedding HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { embeddings: number[][] };
  return data.embeddings[0];
}

function toPgVector(vector: number[]): string {
  return `[${vector.join(",")}]`;
}

async function chat(system: string, user: string): Promise<string> {
  const res = await fetch(`${OLLAMA_BASE}/api/chat`, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({
      model: CHAT_MODEL,
      messages: [
        { role: "system", content: system },
        { role: "user", content: user },
      ],
      stream: false,
    }),
  });

  if (!res.ok) {
    throw new Error(`Chat HTTP ${res.status}: ${await res.text()}`);
  }

  const data = (await res.json()) as { message: { content: string } };
  return data.message.content;
}

// ─── Construction du WHERE dynamique

function buildWhereClause(filters: SearchFilters): {
  clause: string;
  values: unknown[];
} {
  const conditions: string[] = [];
  const values: unknown[] = [];

  function add(condition: string, value: unknown) {
    values.push(value);
    conditions.push(condition.replace("?", `$${values.length + 1}`));
  }

  if (filters.tenant) add("tenant = ?", filters.tenant);
  if (filters.department) add("department = ?", filters.department);
  if (filters.type) add("type = ?", filters.type);
  if (filters.dateFrom) add("document_date >= ?", filters.dateFrom);
  if (filters.dateTo) add("document_date <= ?", filters.dateTo);

  return {
    clause: conditions.length > 0 ? `WHERE ${conditions.join(" AND ")}` : "",
    values,
  };
}

// ─── Retriever avec filtres

type Retriever = (
  question: string,
  filters?: SearchFilters,
) => Promise<RetrievedChunk[]>;

function createRetriever(topK: number): Retriever {
  return async function retrieve(
    question: string,
    filters: SearchFilters = {},
  ) {
    const questionVector = await embed(question);
    const where = buildWhereClause(filters);

    const result = await pool.query<RetrievedChunk>(
      `SELECT
         filename,
         content,
         type,
         department,
         tenant,
         document_date,
         embedding <=> $1::vector AS distance
       FROM documents_metadata
       ${where.clause}
       ORDER BY distance ASC
       LIMIT $${where.values.length + 2}`,
      [toPgVector(questionVector), ...where.values, topK],
    );

    return result.rows;
  };
}

// ─── ResponseSynthesizer : chunks + question → réponse

type ResponseSynthesizer = (
  chunks: RetrievedChunk[],
  question: string,
) => Promise<string>;

function createResponseSynthesizer(): ResponseSynthesizer {
  return async function synthesize(chunks, question) {
    const context = chunks
      .map(
        (chunk) =>
          `[${chunk.filename} | ${chunk.department} | ${chunk.type} | ${chunk.document_date}]\n${chunk.content}`,
      )
      .join("\n\n---\n\n");

    const systemPrompt =
      `Tu es un assistant spécialisé dans les documents d'entreprise. ` +
      `Réponds UNIQUEMENT à partir du contexte fourni. ` +
      `Si le contexte ne contient pas la réponse, dis-le honnêtement. ` +
      `Réponds en français.\n\nContexte :\n${context}`;

    return chat(systemPrompt, question);
  };
}

// ─── QueryEngine : la façade qui relie les deux

type QueryEngine = (
  question: string,
  filters?: SearchFilters,
) => Promise<{ chunks: RetrievedChunk[]; answer: string }>;

function createQueryEngine(
  retriever: Retriever,
  synthesizer: ResponseSynthesizer,
): QueryEngine {
  return async function query(question: string, filters: SearchFilters = {}) {
    const chunks = await retriever(question, filters);
    const answer = await synthesizer(chunks, question);
    return { chunks, answer };
  };
}

// ─── Ingestion avec métadonnées

async function resetTable() {
  await pool.query("DROP TABLE IF EXISTS documents_metadata");
  await pool.query("CREATE EXTENSION IF NOT EXISTS vector");
  await pool.query(`
    CREATE TABLE documents_metadata (
      id SERIAL PRIMARY KEY,
      filename TEXT NOT NULL,
      chunk_index INT NOT NULL,
      content TEXT NOT NULL,
      type TEXT NOT NULL,
      department TEXT NOT NULL,
      tenant TEXT NOT NULL,
      document_date DATE NOT NULL,
      embedding vector(${EMBED_DIM})
    )
  `);
}

function loadDocuments(): Array<{
  filename: string;
  chunks: string[];
  metadata: DocumentMetadata;
}> {
  const files = readdirSync(DATAS_DIR)
    .filter((file) => /^document-\d+\.txt$/.test(file))
    .sort();

  return files.map((filename) => {
    const metadata = DOCUMENT_METADATA[filename];
    if (!metadata) {
      throw new Error(`Métadonnées manquantes pour ${filename}`);
    }

    const content = readFileSync(join(DATAS_DIR, filename), "utf-8").trim();
    const chunks = content
      .split(/\n\n+/)
      .map((chunk) => chunk.trim())
      .filter(Boolean);

    return { filename, chunks, metadata };
  });
}

async function ingestDocuments() {
  console.log("\n=== Ingestion avec métadonnées ===\n");

  const documents = loadDocuments();

  for (const document of documents) {
    for (let i = 0; i < document.chunks.length; i++) {
      const chunk = document.chunks[i];
      const vector = await embed(chunk);

      await pool.query(
        `INSERT INTO documents_metadata
         (filename, chunk_index, content, type, department, tenant, document_date, embedding)
         VALUES ($1, $2, $3, $4, $5, $6, $7, $8)`,
        [
          document.filename,
          i,
          chunk,
          document.metadata.type,
          document.metadata.department,
          document.metadata.tenant,
          document.metadata.documentDate,
          toPgVector(vector),
        ],
      );

      console.log(
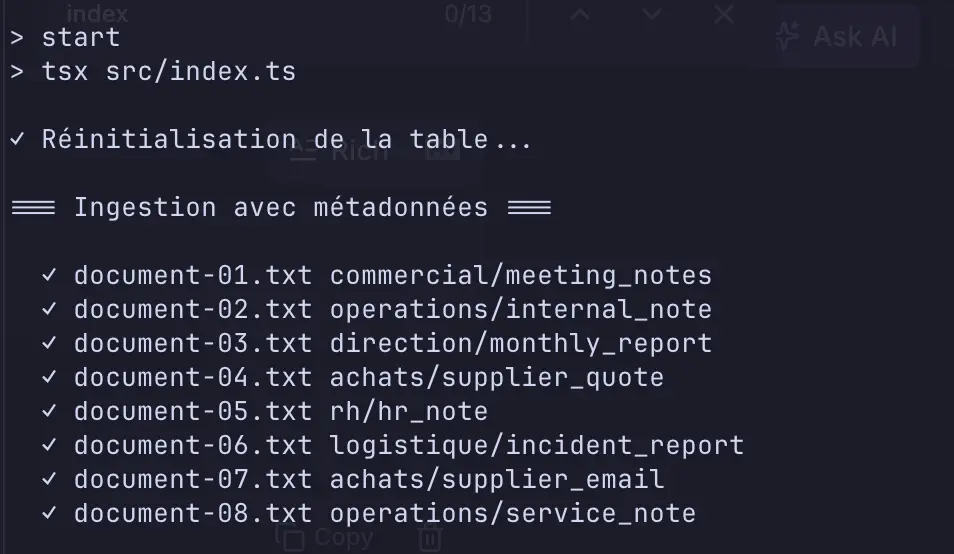
        `  ✓ ${document.filename} ${document.metadata.department}/${document.metadata.type}`,
      );
    }
  }
}

async function withSpinner<T>(label: string, fn: () => Promise<T>): Promise<T> {
  const frames = ["⠋", "⠙", "⠹", "⠸", "⠼", "⠴", "⠦", "⠧", "⠇", "⠏"];
  let i = 0;
  const interval = setInterval(() => {
    process.stdout.write(`\r${frames[i]} ${label}`);
    i = (i + 1) % frames.length;
  }, 80);

  try {
    const result = await fn();
    process.stdout.write(`\r✓ ${label}\n`);
    return result;
  } catch (e) {
    process.stdout.write(`\r✗ ${label}\n`);
    throw e;
  } finally {
    clearInterval(interval);
  }
}

// ─── Point d'entrée

async function ask(
  queryEngine: QueryEngine,
  question: string,
  filters: SearchFilters,
) {
  console.log(`\n❓ Question : ${question}`);
  console.log(`🔎 Filtres : ${JSON.stringify(filters)}\n`);

  const { chunks, answer } = await queryEngine(question, filters);

  if (chunks.length === 0) {
    console.log("Aucun document ne correspond aux filtres.\n");
    return;
  }

  console.log("Résultats filtrés :\n");

  for (const [index, chunk] of chunks.entries()) {
    const preview = chunk.content.slice(0, 150).replace(/\s+/g, " ");
    console.log(
      `  #${index + 1} distance=${Number(chunk.distance).toFixed(4)} ` +
        `${chunk.filename} ${chunk.department}/${chunk.type} ${chunk.document_date}`,
    );
    console.log(`     ${preview}...\n`);
  }

  console.log(`🤖 Réponse :\n${answer}\n`);
}

async function main() {
  await withSpinner("Réinitialisation de la table...", resetTable);
  await ingestDocuments();

  const retriever = createRetriever(3);
  const synthesizer = createResponseSynthesizer();
  const queryEngine = createQueryEngine(retriever, synthesizer);

  console.log("\n=== Recherche sans filtre ===\n");
  await ask(queryEngine, "Que s'est-il passé avec Boulangerie Martin ?", {
    tenant: "demo",
  });

  console.log("\n=== Recherche filtrée par département ===\n");
  await ask(queryEngine, "Que s'est-il passé avec Boulangerie Martin ?", {
    tenant: "demo",
    department: "logistique",
  });

  console.log("\n=== Recherche filtrée par type ===\n");
  await ask(queryEngine, "Quelles informations concernent les congés d'été ?", {
    tenant: "demo",
    type: "hr_note",
  });

  console.log("\n=== Recherche filtrée par période ===\n");
  await ask(
    queryEngine,
    "Quels documents parlent des opérations début juillet ?",
    {
      tenant: "demo",
      department: "operations",
      dateFrom: "2026-07-01",
      dateTo: "2026-07-10",
    },
  );

  console.log("\n=== Filtre trop restrictif ===\n");
  await ask(queryEngine, "Que s'est-il passé avec Boulangerie Martin ?", {
    tenant: "demo",
    department: "rh",
  });

  await pool.end();
}

main().catch(async (err) => {
  console.error(`\nErreur : ${err.message}`);
  await pool.end();
  process.exit(1);
});
Exécution
Lance :
npm startTu devrais voir l’ingestion avec les métadonnées :
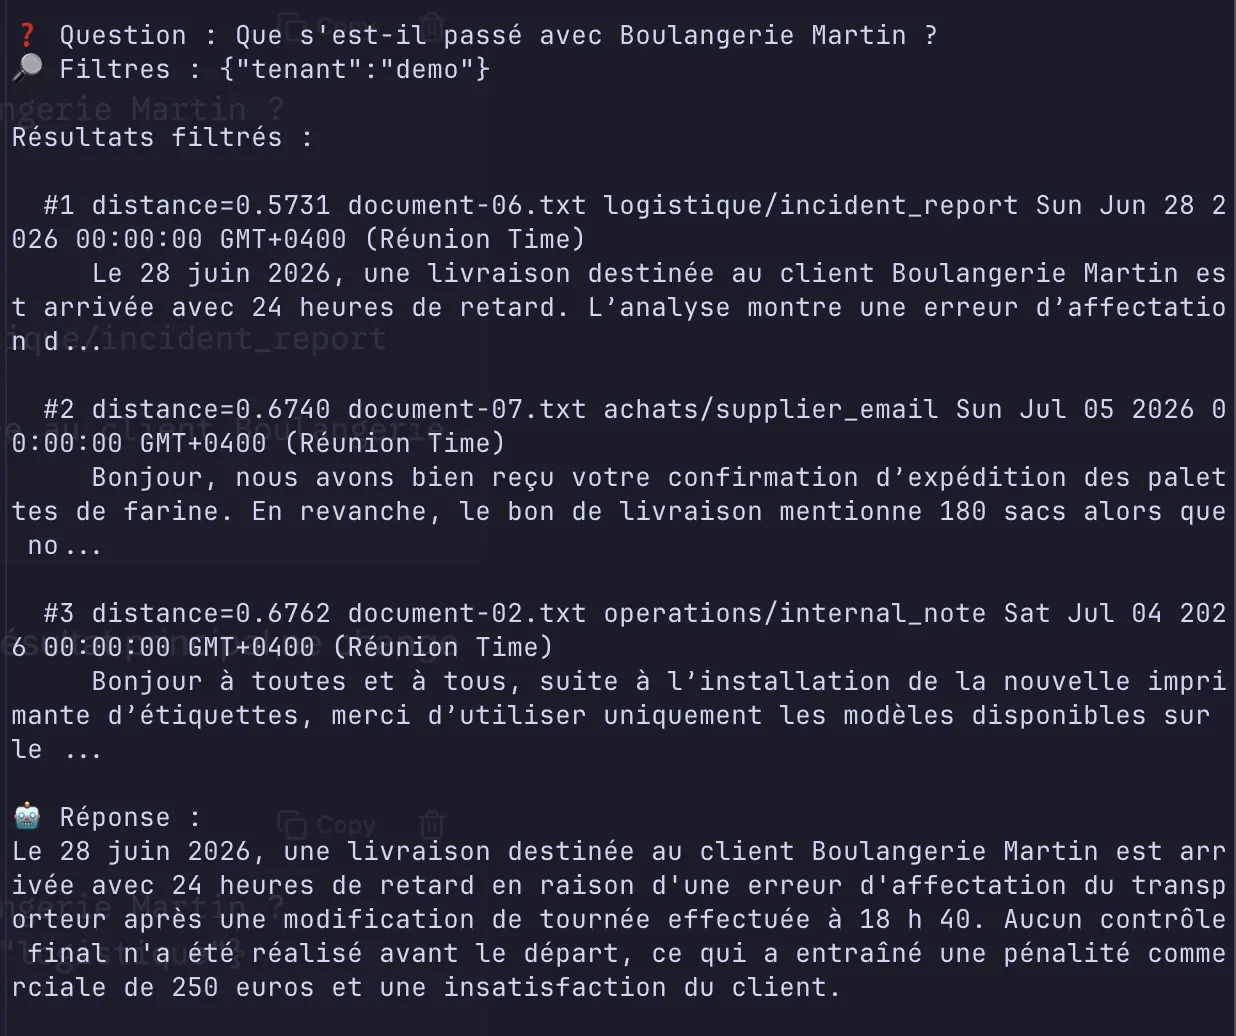
Puis une recherche sans filtre. Ici le filtre tenant: demo ne restreint rien, puisque tous nos documents sont dans le tenant demo :
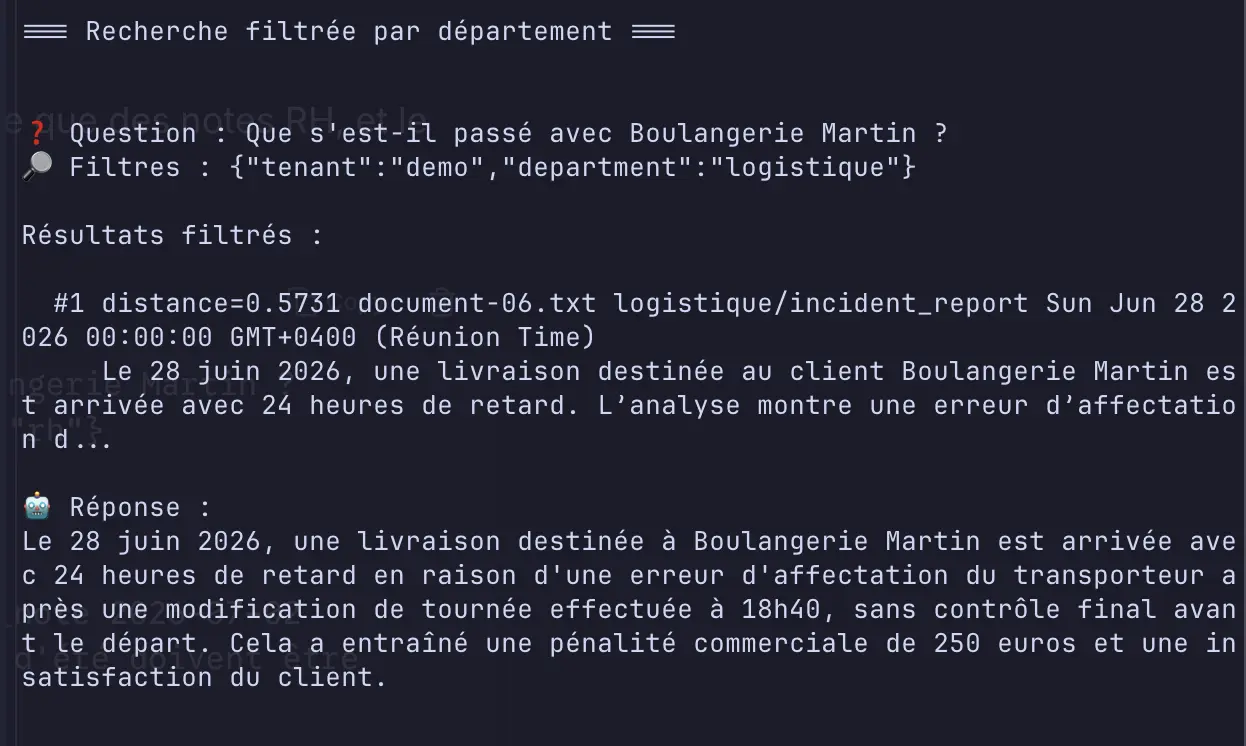
Et la même recherche filtrée par département. Le résultat principal ne change pas, car l’incident est bien dans logistique :
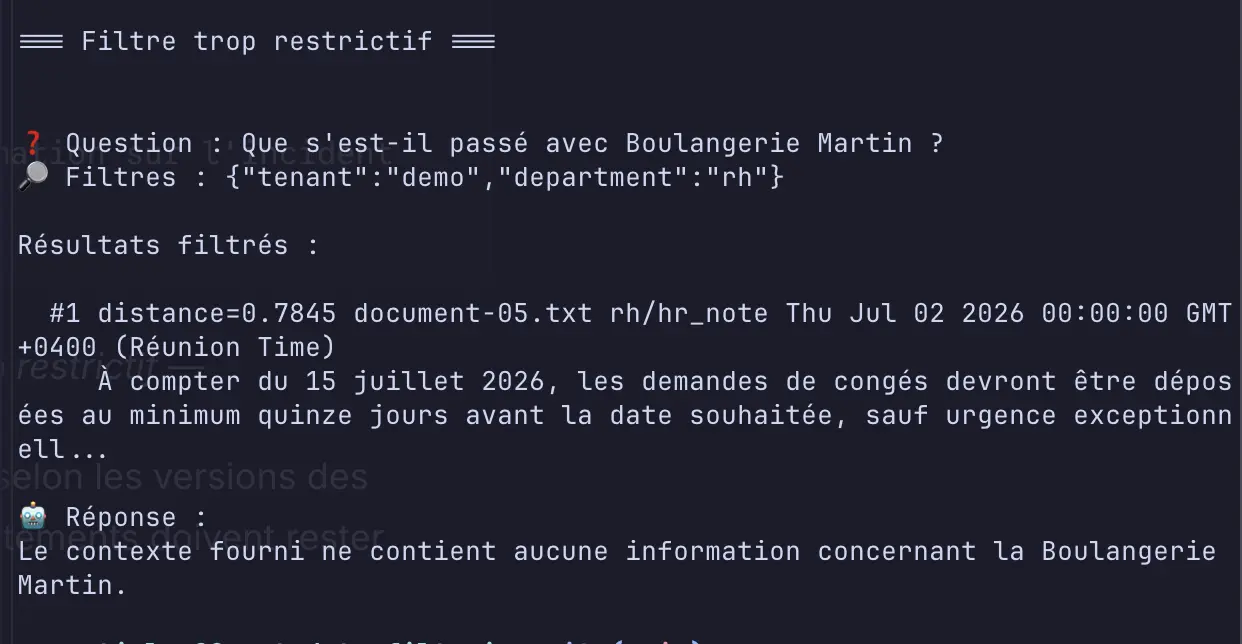
Enfin, le filtre trop restrictif : le retriever ne retrouve que des notes RH, et le LLM doit refuser d’utiliser le contexte :
Comment fonctionne le WHERE dynamique
Le point intéressant du code est ici :
function buildWhereClause(filters: SearchFilters) {
  const conditions: string[] = [];
  const values: unknown[] = [];

  function add(condition: string, value: unknown) {
    values.push(value);
    conditions.push(condition.replace("?", `$${values.length + 1}`));
  }

  if (filters.tenant) add("tenant = ?", filters.tenant);
  if (filters.department) add("department = ?", filters.department);
  if (filters.type) add("type = ?", filters.type);
  if (filters.dateFrom) add("document_date >= ?", filters.dateFrom);
  if (filters.dateTo) add("document_date <= ?", filters.dateTo);

  return {
    clause: conditions.length > 0 ? `WHERE ${conditions.join(" AND ")}` : "",
    values,
  };
}
On construit uniquement les filtres présents.
Si l’utilisateur fournit :
{
  tenant: "demo",
  department: "logistique"
}
La requête devient :
WHERE tenant = $2
  AND department = $3
Le vecteur de la question reste $1.
C’est pour ça que le code utilise :
[toPgVector(questionVector), ...where.values, topK];Le plus important : on garde des paramètres SQL. On ne concatène jamais directement les valeurs utilisateur dans la requête.
Filtrer avant ou après la recherche vectorielle ?
On filtre avant.
La requête :
SELECT ...
FROM documents_metadata
WHERE tenant = 'demo'
  AND department = 'logistique'
ORDER BY embedding <=> query_vector
LIMIT 3;
signifie :
-
garde seulement les documents du tenant
demo; -
garde seulement le département
logistique; -
calcule les distances vectorielles dans ce sous-ensemble ;
-
retourne les 3 plus proches.
Si on faisait l’inverse, on pourrait récupérer les meilleurs documents globaux, puis en supprimer certains après coup. Résultat : il ne resterait parfois aucun bon chunk, même s’il existait dans le bon périmètre.
Le filtre tenant n’est pas optionnel
Dans une application multi-tenant, le filtre le plus important est :
WHERE tenant = $2Ce n’est pas une optimisation. C’est une frontière de sécurité.
Un utilisateur du tenant A ne doit jamais pouvoir récupérer un chunk du tenant B, même si ce chunk est sémantiquement proche de sa question.
Donc en production :
-
le
tenantne vient pas du prompt utilisateur ; -
il vient de l’authentification ;
-
il est appliqué côté serveur ;
-
il est présent dans toutes les requêtes retrieval.
Le LLM ne doit pas décider du tenant. Le backend le sait déjà.
Les filtres améliorent aussi la qualité
La sécurité n’est pas le seul intérêt.
Un filtre métier peut améliorer la pertinence :
await ask(queryEngine, "Quelles informations concernent les congés d'été ?", {
  tenant: "demo",
  type: "hr_note",
});
Ici, on évite que des documents logistiques ou commerciaux remontent simplement parce qu’ils contiennent aussi une date ou une action à faire.
Le filtre dit :
cherche seulement dans les notes RHLa recherche vectorielle dit ensuite :
parmi ces notes RH, trouve la plus proche de la questionLes deux approches se complètent.
Attention aux filtres trop stricts
Un mauvais filtre peut cacher la bonne réponse.
Exemple :
await ask(queryEngine, "Que s'est-il passé avec Boulangerie Martin ?", {
  tenant: "demo",
  department: "rh",
});
L’incident Boulangerie Martin est dans logistique, pas dans rh.
Le système n’a donc que deux comportements corrects :
-
aucun résultat si le filtre élimine tout ;
-
ou des résultats RH non pertinents, que le LLM doit refuser d’utiliser.
C’est pour ça que les filtres doivent venir d’une intention claire :
-
permissions utilisateur ;
-
page courante ;
-
document sélectionné ;
-
période choisie ;
-
type de recherche explicite.
Il ne faut pas filtrer “au hasard” parce que ça semble plus propre.
Métadonnées structurées vs prompt
Mauvaise idée :
Réponds seulement avec les documents RH du tenant demo.Cette consigne dans le prompt arrive trop tard. Les chunks sont déjà récupérés.
Bonne idée :
WHERE tenant = 'demo'
  AND department = 'rh'
Le filtre est appliqué avant le LLM, dans la base de données.
Règle simple :
Les contraintes de sécurité et de périmètre appartiennent au backend, pas au prompt.
Index SQL utiles
Pour notre petit dataset, aucun index classique n’est nécessaire.
Mais en production, on ajouterait des index sur les colonnes de filtre :
CREATE INDEX documents_metadata_tenant_idx
ON documents_metadata (tenant);
CREATE INDEX documents_metadata_department_idx
ON documents_metadata (department);CREATE INDEX documents_metadata_type_idx
ON documents_metadata (type);Et plus tard, un index vectoriel :
CREATE INDEX documents_metadata_embedding_idx
ON documents_metadata
USING hnsw (embedding vector_cosine_ops);
On ne les ajoute pas encore dans le script pour rester lisible. Mais c’est le chemin naturel vers la production.
Ce qu’on a appris
-
Metadata filtering — limiter le périmètre avant la recherche vectorielle
-
Le filtre est un paramètre du retriever — le query engine reste inchangé, c’est le retriever qui porte les filtres
-
Sécurité — le filtre
tenantest une frontière backend, pas une préférence du LLM -
Pertinence — filtrer par type, département ou date réduit le bruit
-
WHERE avant ORDER BY — PostgreSQL filtre d’abord, puis classe par distance vectorielle
-
Filtres trop stricts — ils peuvent cacher le bon document
-
Prompt insuffisant — les règles de périmètre doivent vivre dans SQL, pas seulement dans le prompt
Le RAG commence à ressembler à une vraie application backend : pas seulement embeddings + LLM, mais aussi données structurées, permissions, requêtes SQL et choix de périmètre.
Prochain article
De Dev Web à Ingénieur IA #10 — Hybrid Search — on va combiner recherche vectorielle et recherche lexicale BM25, puis fusionner les résultats pour améliorer le retrieval.